Denne siden handler om hvordan tale genereres: sammenkjedede klipp, parametriske vokodere, rå lyd i WaveNet-stil og de nevrale modellene som GSpeech ruter i dag. Det er ikke en «hvorfor legge til en spiller»-liste – som lever videre fordeler med nettsteds-TTSDet er heller ikke en gjennomgang av WordPress-installasjon.
På et aktivt nettsted velger du ikke en forskningsartikkel. Du velger en stemme i Cloud Console. Under det valget, Enhetlig AI-stemmemotor (kommersiell) kan bruke OpenAI, Gemini, Google Cloud, Chirp3 HD, Neural2, Polyglot og WaveNet – ingen API-nøkler kreves. Skybasert prosessering, ingen serverbelastning holder syntesen utenfor opprinnelsesstedet.
Syntesepipelinen (hva som faktisk skjer)
Talesyntese gjør skrevne tokens om til en bølgeform. En nettstedsspiller er bare det siste hoppet: spill av en fil. Det interessante arbeidet er tidligere.
- Tekst inn - isolert artikkel, uthevet spenn (RHT) eller en oversatt streng. Isolering er produktarbeid, ikke en vocoder-artikkel.
- Språklig analyse - ord, trykk, pauser. Smarte uttalealiaser sitter her: merkestrenger som modellen ellers ville gjettet.
- Akustisk modell - sammenkjedede enheter, en parametrisk vokoder eller et nevralt nettverk som forutsier lyd.
- Bølgeform ut – lagret én gang under Generer én gang, Behold og spill av, deretter strømmet. Nettleser speechSynthesis hopper over denne butikken og bruker det operativsystemet som ble levert.
Tre familier av TTS-modeller
Sammenkoblet TTS lagrer korte høyttalerklipp og rekombinerer dem. Å bytte høyttaler eller følelse betyr vanligvis å spille inn en ny database. Klassiske Siri-stilstabler brukte denne ideen.
Parametrisk TTS holder taleegenskapene i modellparametere. Tidlige versjoner hørtes ofte mindre naturlige ut enn sammenkjedede versjoner fordi lyden gikk gjennom en vocoder.
Nevrale systemer ligger oppå den historien. Regelbaserte og statistiske stabler finnes fortsatt i lærebøker. Det du hører på GSpeechs kommersielle stemmer er AI-syntese: OpenAI, Gemini, Google Cloud Neural2 / Polyglot / Chirp3 HD og WaveNet – ikke en lokal sammenkjedet bank på PHP-verten din.
WaveNet: modellering av råbølgeformen
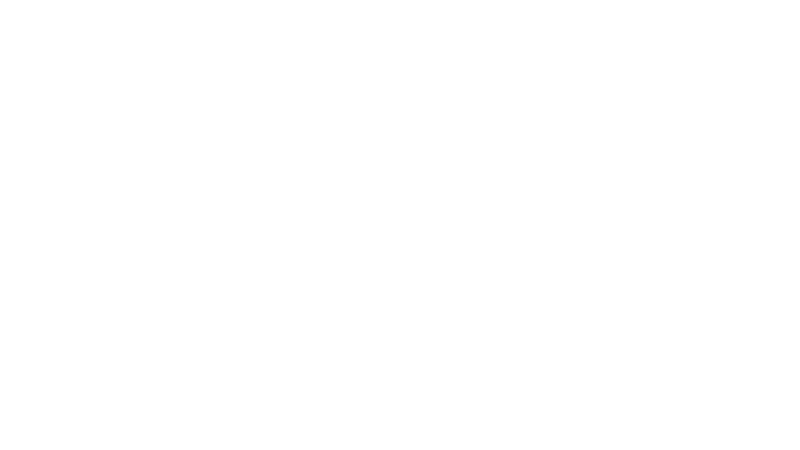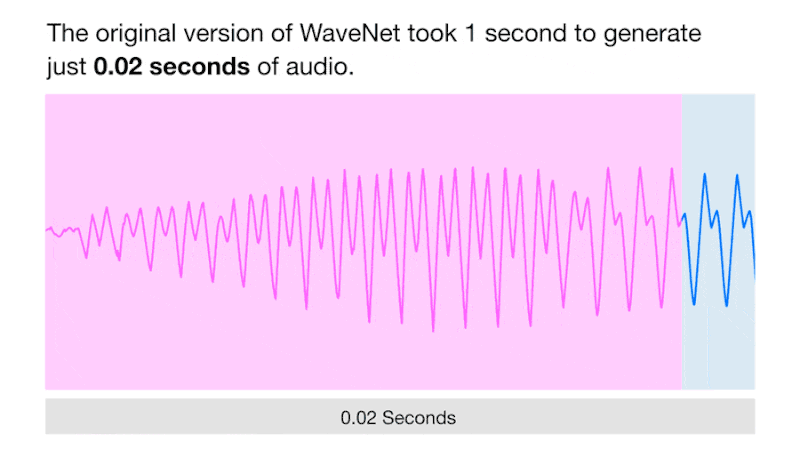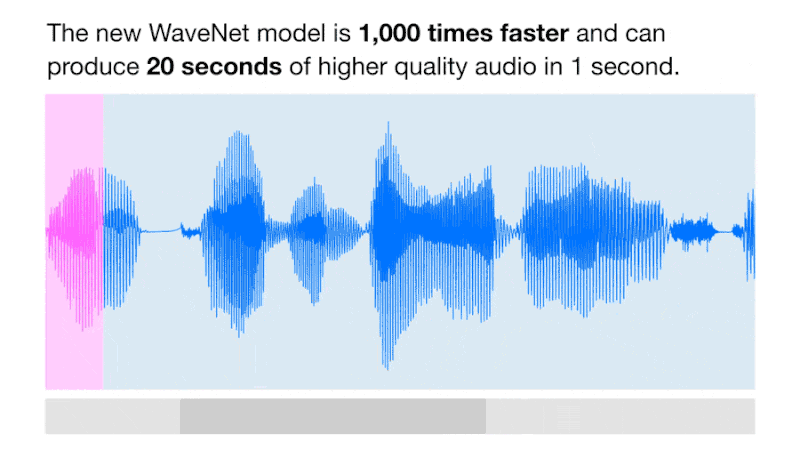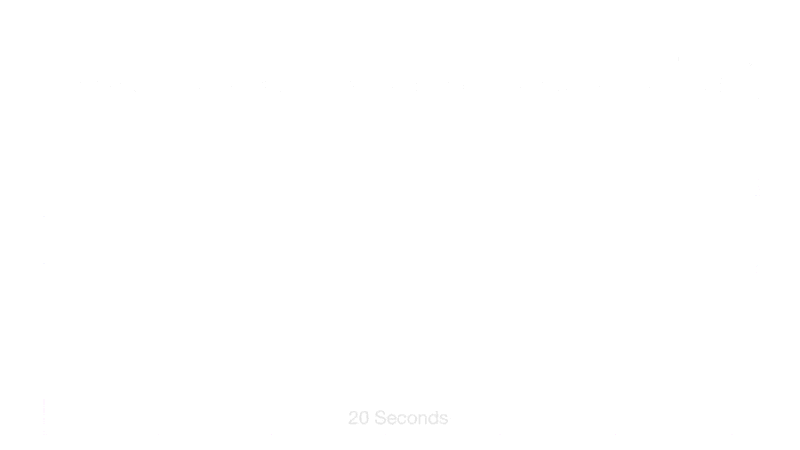
WaveNet endret den parametriske historien ved å forutsi lydsignalet sample for sample i stedet for å gi et kompakt spektrogram til en vokoder. Googles arbeid fra 2016 viste at et utvidet konvolusjonsnett kan dekke tusenvis av tidssteg. Rå lyd er tett – vanligvis 16 000 sampler per sekund eller mer – så autoregressiv generering er dyrt, men det fanger opp leppesmekk og høyttaler-eienheter som sammenkjedet lim ofte bommer på.
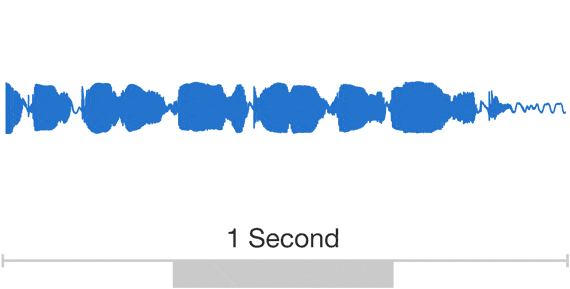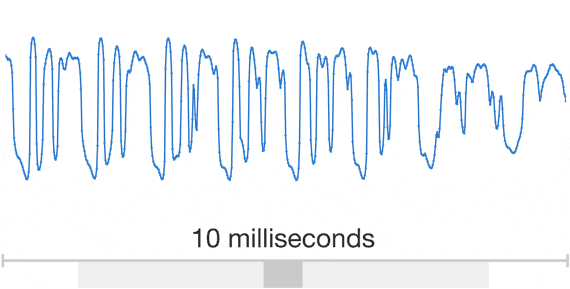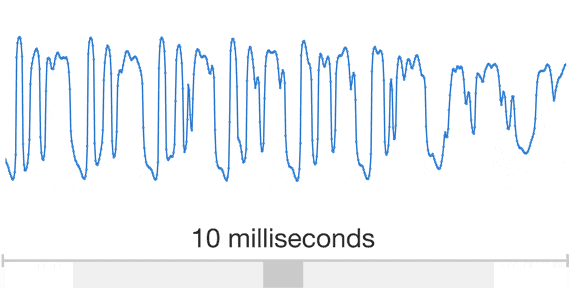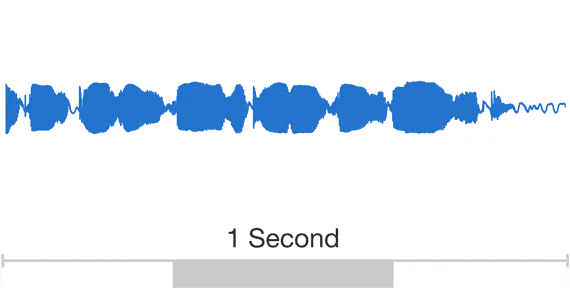
PixelRNN og PixelCNN viste at det var mulig å generere et bilde én kanal om gangen. WaveNet er 1D-versjonen av den ideen: et fullstendig konvolusjonelt nettverk der dilatasjonsfaktorene øker det reseptive feltet eksponentielt.
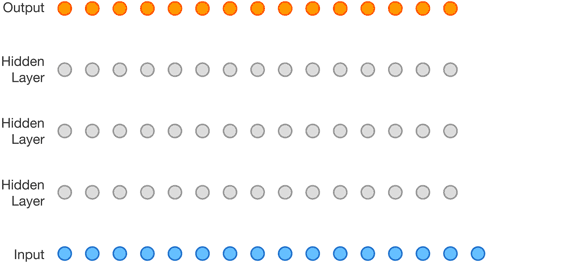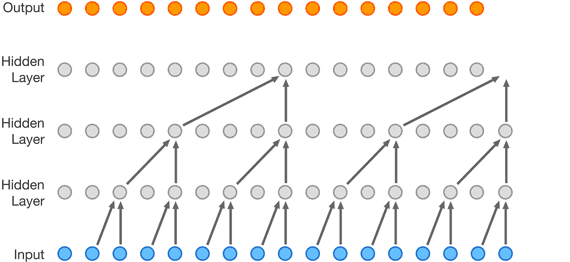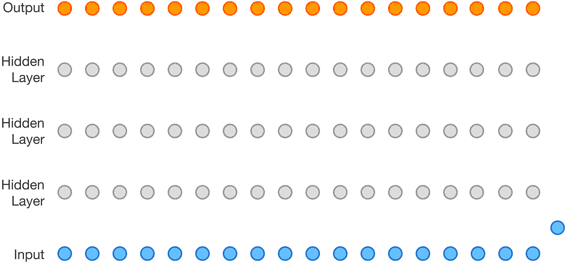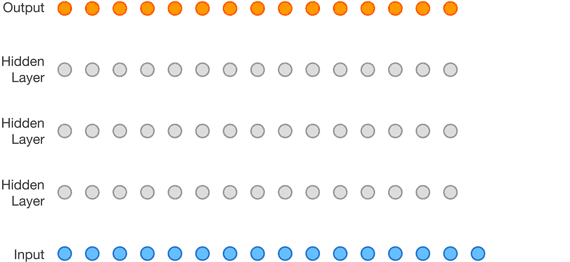
Ved treningstidspunktet er inngangene reelle, registrerte bølgeformer. Ved samplingstid henter hvert trinn fra nettverkets forutsagte fordeling, mater den samplen tilbake og fortsetter. Denne løkken er grunnen til at tidlig WaveNet kun var forskningsbasert beregning; senere stabler slanket det ned til produksjons-Google TTS.
MOS og gapet i 2016
Google evaluerte WaveNet mot daværende beste parametriske og sammenkoblede systemer ved bruk av Gjennomsnittlig meningspoeng (MOS) – blinde menneskelige vurderinger (over 500 vurderinger på 100 testsetninger i den opprinnelige rapporten). WaveNet reduserte det gjenværende gapet til menneskelig tale med mer enn halvparten for amerikansk engelsk og mandarin-kinesisk i disse testene. Det er en forskningsmilepæl, ikke en GSpeech-markedsføringspoengsum.
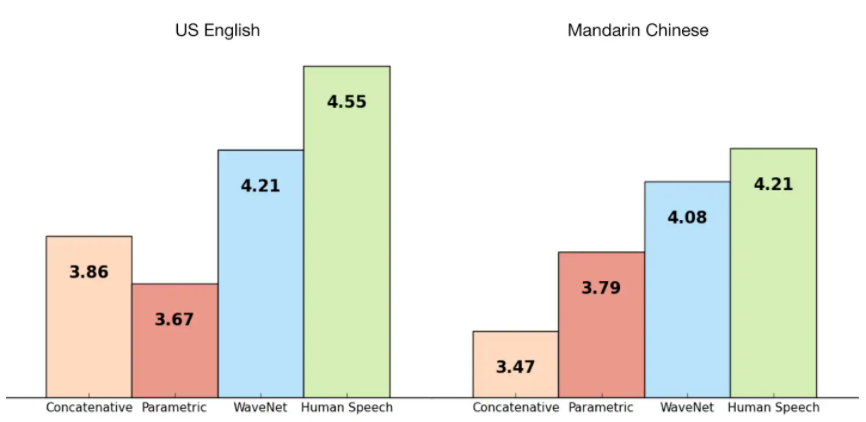
WaveNet er én familie i Unified AI Voice Engine. Senere stabler - Gemini TTS, Chirp3 HD, Neural2, Polyglot og OpenAI – er det du velger som en stemme i Cloud Console. Du distribuerer ikke et WaveNet-sjekkpunkt på WordPress.
Gemini TTS: promptstyrt tale
WaveNet forutså den neste lydprøven. Gemini TTS er en senere talegenereringssti fra Google: du beskriver hvordan det leste skal høres ut i naturlig språk – stil, aksent, tempo, tone, følelser, fremføring – og modellen utfører den instruksjonen. Det er derfor GSpeech tilpassede talemeldinger og Stemmevibber (stiler, ikke ekstra stemme-ID-er) er viktige på Gemini: kontrollen ligger i ledeteksten, ikke i en ny sammenkjedet bank.
Språklig opprydding skjer fortsatt først. Smarte uttalealiaser kan utvide et akronym eller låse et merkevaretoken; Gemini leser deretter den forberedte strengen med den forespurte leveringen. Offisielle API-notater: Gemini TTS.
Gemini-fortelling med høyest mulig kvalitet når lyttepasset er en del av siden: flaggskipinnlegg, merkevareforklaringer, produkttekst.
Samme ledetekstspråk som Pro, justert for raskere generering på tvers av en katalog med innlegg eller SKU-er.
Gemini Pro
Gemini Pro er den ultrarealistiske Gemini TTS-modellen i GSpeech. Du skriver en tilpasset talemelding slik du ville orientert en forteller: roligere produktforklaring, lysere blogginnlegg, strammere aksent, lavere tempo, mer følelser. Den synlige HTML-koden forblir ren for lesere og SEO. Det finnes ingen separat Gemini-nøkkel, intet Google AI Studio-prosjekt, ingen ekstra leverandørkonsoll.
Teknisk sett er dette fortsatt skysyntese, deretter en lagret fil. Gjentatte lyttinger er avspilling, ikke en ny Gemini-tur/retur. Bruk Pro når lyden er opplevelsen – en hovedartikkel eller en produktside der leveringen skal føles målrettet, ikke generisk.
Gemini Flash
Gemini Flash er den samme Gemini TTS-familien, bygget for hastighet. Det umiddelbare ordforrådet matcher Pro (stil, aksent, tempo, tone, følelser, fremføring), slik at du kan utarbeide en taleanvisning én gang og bruke den på nytt mens Flash blar om sidene raskere. Katalogens arbeidshest: mange innlegg, WooCommerce-beskrivelser, flerspråklige utkast. Forfrem en hoved-URL til Pro når du vil ha den siste ytelsen.
Chirp3 HD: Google Cloud’s current HD neural family
Chirp3 HD er ikke «WaveNet med et nytt navn». WaveNet (2016) modellerte rå lyd med utvidede konvolusjoner. Neural2-, Polyglot- og WaveNet-stemmer finnes fortsatt i Google Cloud-katalogen (den 230 + etasje: Standard, WaveNet, Neural2, Polyglot, Journey, Studio, News). Chirp3 HD er Googles senere generasjon av HD Cloud TTS – bygget for realisme og naturlig intonasjon snarere enn flat høytlesning. Offisielle notater: Chirp 3 HD.
Inne i GSpeech er Chirp3 HD en Cloud Console-stemme: ikke noe Google Cloud-prosjekt, ingen tjenestekonto-JSON. Du velger stemmen; syntesen kjører fra opprinnelsen din; filen lagres og spilles av via Full Page, Button, Circle, Floating, Context eller RHT. Hastighet og tonehøyde forblir i konsollen. Merkenavn hører fortsatt hjemme i Smart Pronunciation Aliases – det laget er uavhengig av hvilken Google-familie du valgte.
Når du bør velge Chirp3 HD vs. Gemini: Chirp3 HD når du ønsker produksjonskvalitet i Google Cloud HD og en konsistent, enhetsuavhengig lesning. Gemini Pro/Flash når du ønsker naturlig språklig kontroll over stil og følelser. Begge er kommersielle Unified AI Voice Engine-baner. Totalt antall motorer er 300+ stemmer tvers 98 språk (Gemini ~30 × 3 for Chirp 3 HD, Flash og Pro per språk, pluss OpenAI 11 × 2, pluss Google Cloud-katalogen). Voice Vibes er stiler, ikke ekstra ID-er.
- Nevral2 – mye brukte produksjonsnevrale stemmer i den samme Google Cloud-katalogen.
- polyglot - sterkere flerspråklig / tverrspråklig ytelse.
- WaveNet – 2016-familien av råbølgeformer, fortsatt tilgjengelig som katalogstemmer, ikke den eneste Google-løsningen.
Unified AI Voice Engine kontra nettleser-TTS
Enhet speechSynthesis er et lokalt API. Stemmer varierer avhengig av operativsystem. Det finnes ingen «Generer én gang, behold og spill av»-fil, ingen smart lydsynkronisering når CMS-kopien endres, og ikke noe «Voice Vibes»-ledetekstlag. GSpeech Cloud Processing kjører modellen i skyen, lagrer filen, og widgeten spiller den av. Midlertidige genereringsproblemer sletter ikke tidligere genererte filer. Filer fjernes ikke når en konto går tilbake til gratisabonnementet. Ny generasjon følger fortsatt det aktive abonnementet.
models:  "OpenAI, Gemini, Google Cloud, Chirp3 HD, Neural2, Polyglot, WaveNet"
langs:    "98 languages, 300+ voices (commercial)"
control: "Voice Vibes + Smart Pronunciation Aliases"
keys:    "No API Keys Required"
Voice Vibes (kommersielle) er i prompt-side-stil, ikke en ny sammenkjedet bank. Aliaser fikser hvordan et token leses uten å endre den synlige HTML-koden. Begge er kontrolllag oppå den akustiske modellen motoren valgte for den stemmen.
Vanlige spørsmål om tekst-til-tale-teknologi
Modeller og pipelines – ikke plugin-oppsett.
-
Bruker GSpeech WaveNet på hver lytt?
Nei. WaveNet er én Google-familie blant flere. Unified AI Voice Engine ruter også Neural2, Polyglot, Chirp3 HD, Gemini og OpenAI avhengig av stemmen du velger. Generer én gang, behold og spill av betyr at gjentatte avspillinger bruker den lagrede filen, ikke en fersk forskningslignende samplingsløkke.
-
Hvorfor nevnes fortsatt sammenkoblet TTS?
Det er den historiske grunnlinjen: sammenføyning av innspilte enheter. Nevrale modeller genererer lyd i stedet for å lime stavelser. Å forstå sammenkobling kontra WaveNet forklarer hvorfor moderne kommersielle stemmer kan endre stil uten en ny innspillingsøkt.
-
Kan jeg kjøre disse modellene på min egen server?
GSpeechs nettstedsprodukt er skybasert behandling, ingen serverbelastning. Du er ikke vert for WaveNet, Gemini eller OpenAI på WordPress. Ingen API-nøkler kreves: fakturering og nøkler forblir i Cloud Console.
-
Gjelder MOS fra 2016 for GSpeech i dag?
MOS-diagrammet på denne siden er Googles publiserte WaveNet-evaluering. GSpeech hevder ikke det samme tallet for alle nåværende stemmer. Nåværende kommersiell kvalitet kommer fra søkemotormiksen ovenfor, ikke fra å trykke en 2016 MOS som en produktpoengsum.
-
Gemini Pro vs. Gemini Flash – hva er forskjellen?
Samme Gemini TTS-familie og samme tilpassede talemeldingsspråk (stil, aksent, tempo, tone, følelser, levering). Flash er raskere for kataloger; Pro er den mer nøyaktige banen for flaggskipsider. Ingen av delene krever en Gemini API-nøkkel i GSpeech – du velger stemmen i Cloud Console.
-
Er Chirp3 HD det samme som WaveNet?
Nei. WaveNet er Googles familie av rå bølgeformmodeller fra 2016. Chirp3 HD er en senere generasjon av HD Cloud TTS for realisme og intonasjon. Neural2-, Polyglot- og WaveNet-stemmer finnes fortsatt i Google Cloud-katalogen (over 230). GSpeech eksponerer Chirp3 HD som en konsollstemme uten et Google Cloud-prosjekt.
Fra papir til en stemme i konsollen
Konkatenative banker, parametriske vokodere og WaveNets råbølgeform-innsats er avstamningen. Gemini TTS (Pro/Flash) legger til rask og kontrollert levering; Chirp3 HD er Google Clouds nåværende HD-nevrale familie. På et GSpeech-nettsted hører du den nåværende Unified AI Voice Engine gjennom en widget – Fullside, Knapp, Sirkel eller Les uthevet tekst (RHT) – med filer som beholdes etter første generasjon. For «bør nettadressen min ha en spiller», bruk fordelsartikkelen. For wp-admin-klikk, bruk veiledningen.
